

易观分析:具身数据当前的核心矛盾,已不再是“数据总量不够”,而是“量、质、异构”三重结构性卡点相互纠缠、彼此放大。要破局,不能指望某一项技术单点突围,必须从“造、治、用、通”四个环节协同发力——把数据从各家自守的“企业私产”,升级为全行业可复用的“公共基础设施”。
一、具身数据的本质特征
易观分析在近期发布的《中国具身数据市场分析报告2026》中列出了具身智能产业的三大挑战:高性能本体部件制造仍面临制造难题;资本节奏与技术周期错配;高质量、大规模的动作与行为数据仍处于稀缺状态、泛化能力不足。其中第三项是决定性的。
报告的判断是:硬件门槛正在被快速跨越,产业已初步解决“机器人能不能动”的问题,真正决定产业天花板的已不再是硬件能力,而是“数据能不能喂饱模型”。机器人在单一任务中表现较好,但环境变化或多任务叠加时成功率明显下降,反映出真实物理世界数据覆盖度不足。
这个瓶颈之所以难破,是因为具身数据的本质特征与传统AI数据根本不同。
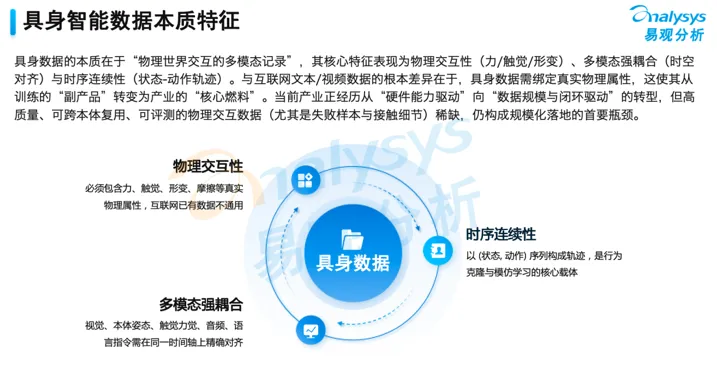
图1:具身数据的本质特征
具身数据的本质是“物理交互世界的多模态记录”,其核心特征表现为:物理交互性(必须包含力、触觉、形变、摩擦等真实物理属性,互联网已有数据不通用)、多模态强耦合(视觉、本体姿态、触觉力觉、音频、语言指令需在同一时间轴上精确对齐)、时序连续性(以“状态—动作”序列构成轨迹,是行为克隆与模仿学习的核心载体)。换句话说,具身数据不是互联网数据的延伸,而是一种必须绑定真实物理属性的新数据品类;它因此从训练的“副产品”变成了产业的“核心燃料”。
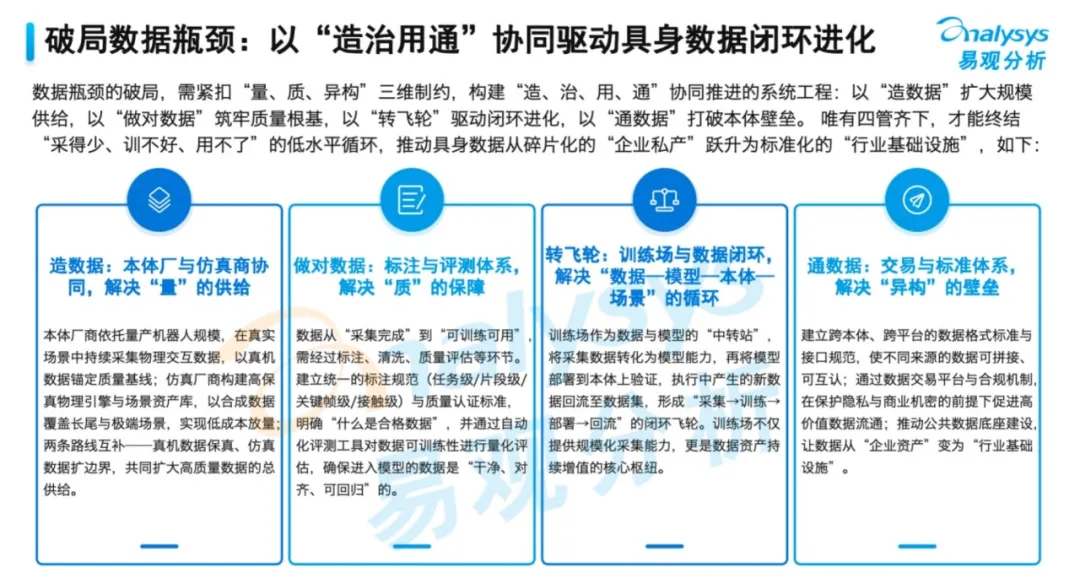
图2:具身数据的瓶颈破局
二、造数据:三条供给线互补,解决“量”
1. 真机数据保真
本体厂商依托量产机器人规模,在真实场景中持续采集物理交互数据,以真机数据锚定质量基线。智元机器人2025年全年出货量突破5000台,三大产品线(轮式人形、四足、人形)均超过1000台——量产的本体本身就是分布式的采集终端。宁德时代投入运行全球首条人形具身智能机器人规模化的新能源动力电池PACK生产线,意味着机器人已经在真实产线上干活,产线本身成为最稳定的真机数据源。
2. 仿真数据扩边界
仿真厂商构建高保真物理引擎与场景资产库,以合成数据覆盖长尾与极端场景,实现低成本放量。群核科技以十余年家装设计沉淀的5亿+结构化3D场景、4.8亿带物理参数的3D模型(约6000万可公开调用)、1800万套设计方案,把渲染空间转成物理正确的三维表示,且获取成本已在过去摊销完毕;光轮智能的SimFoundry自研GPU物理求解器,仿真路线边际成本约为真机的1%;无问智科构建了百万级SimReady资产库,并配套“无穹”世界模拟器。三家走的是同一条路:先把物理正确性做硬,再用规模化摊薄成本。
3. 无本体采集铺量
人穿戴设备直接记录动作,成本降至真机的1/3左右,结合众包模式走向“伴随化采集”——普通员工边工作边采。觅蜂科技MEgo设备累计下线约2万台,累计产出超100万小时,覆盖22大类场景、1万余个真实环境;鹿明机器人的FastUMI形成Pro/Ego/Go三种形态,其中Go为背包版、计划投放约1万台,单条采集成本降至传统遥操作的1/5。随着无本体设备国产化叠加众包网络成熟,部分场景下“真实众包”可能比“仿真合成”更便宜。
三条线不是竞争关系,而是围绕“数据金字塔”各司其职:真机锚定质量、仿真放大规模、无本体补充真实。
三、“治”数据:标注与评测体系,解决“质”
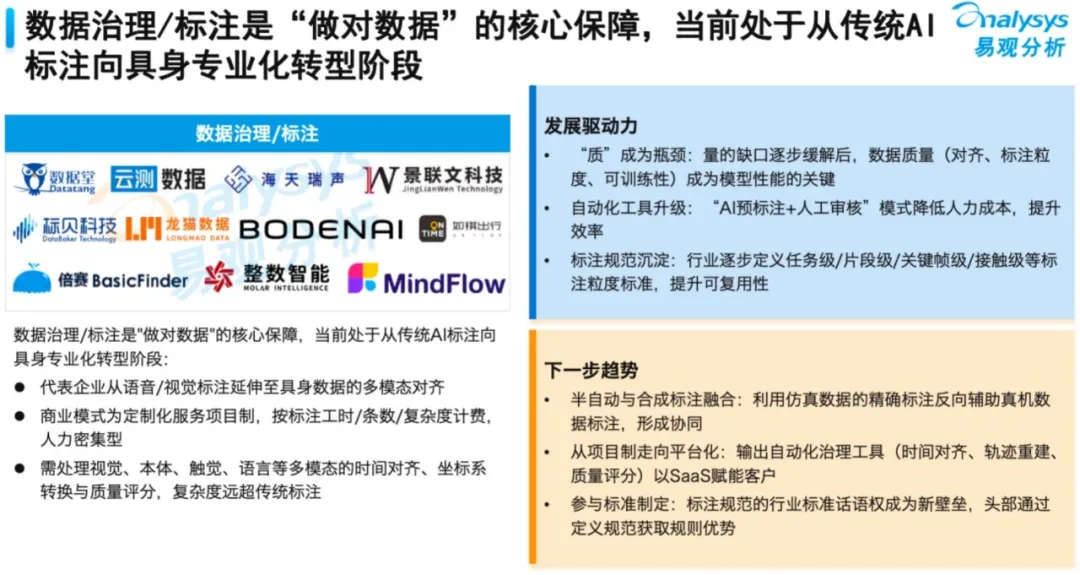
图3:数据治理与标注板块的发展特征
数据从“采集完成”到“可训练可用”,中间隔着标注、清洗、质量评估三道工序。报告给出的解法是建立统一的标注规范与质量认证标准,明确“什么是合格数据”,并通过自动化评测工具对数据可训练性进行量化评估,确保进入模型的数据是“干净、对齐、可回归”的。
行业正在逐步定义四级标注粒度:任务级、片段级、关键帧级、接触级。分级的意义在于把“标注”从人工计时劳动,变成可定价、可验收的工程规格。
企业侧的实践已经初步给出量化结果。鹿明机器人建立了8道工序的工业级数据质量评估体系,数据有效率从行业普遍的70%提升到95%以上,只交付可复现轨迹。无问智科的“无垠”自动化管线把Raw到Model-Ready的效率提升500%—1000%;觅蜂科技的MEgo Engine自研VIO位姿算法,支持空间重建与长时序自动切分,效率较人工提升10倍,并做到毫米级轨迹重建与亚毫秒全局同步。海天瑞声、景联文等传统标注企业正从语音/视觉标注延伸至具身数据的多模态对齐,处理视觉、本体、触觉、语言的时间对齐、坐标系转换与质量评分的复杂度,远超传统标注。
合规是“质”的另一半。光轮智能的数据集做到全量脱敏授权,这是数据集能被复售、能被十余家客户重复采购的前提。
四、转飞轮:训练场作为枢纽,解决“循环”
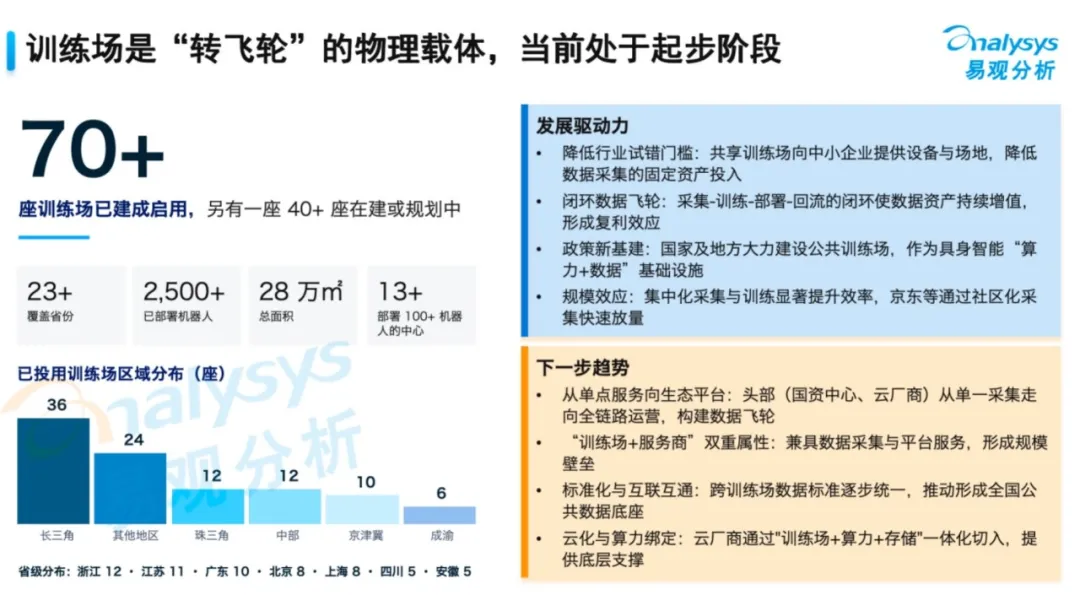
图4:数据训练场的发展现状
训练场是数据与模型的“中转站”:把采集数据转化为模型能力,再把模型部署到本体上验证,执行中产生的新数据回流至数据集,形成“采集→训练→部署→回流”的闭环飞轮。
企业侧已经开始把训练场当成生产设施运营。无问智科在长三角(德清)建了室内3000㎡、室外505亩的训练场,开放场景达937平方公里,日产数据上千小时;京东等通过社区化采集快速放量,是规模效应的另一种形态;光轮智能用RoboStack做真机部署与回流编排,支持百台级集群与失败样本回传——回流回来的不只是数据,更是“哪里会失败”的信息。
训练场的核心价值不只是提供采集场地,而在于把固定资产投入变成可变成本——中小企业不必重资产自建,也能进入数据采集与训练环节。
五、“通”数据:标准与交易体系,解决“异构”
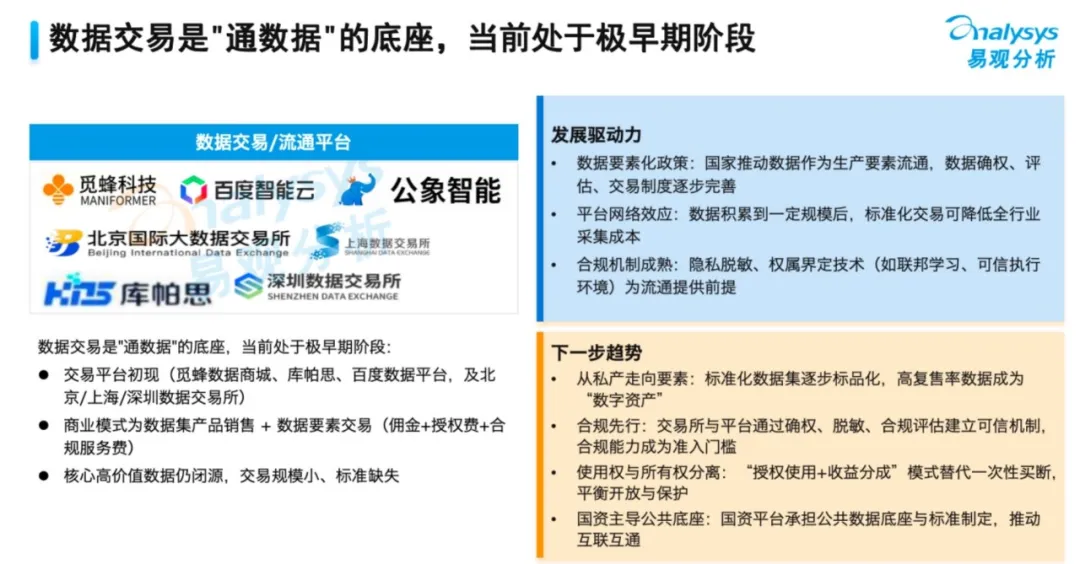
图5:数据交易板块的发展现状
异构是当前最容易被低估的卡点。报告拆成三层:本体异构(各家关节数、坐标系、控制频率不同,一家本体采集的数据无法直接用于训练另一家本体的模型,换本体等于重采、重标、重训);格式孤岛(JSON、Parquet、ROS bag等格式并存,跨平台不可拼接、不可审计);数据孤岛(全国各训练场数据尚未连接,核心高价值数据因护城河与合规顾虑难以流通)。
解法是建立跨本体、跨平台的数据格式标准与接口规范,使不同来源的数据可拼接、可互认;通过数据交易平台与合规机制,在保护隐私与商业机密的前提下促进高价值数据流通;推动公共数据底座建设。
产业侧的动作已经开始。解耦层面:鹿明机器人的FastUMI与本体解耦,适配市面90%以上机械臂;光轮智能的RoboFinals支持异构本体接入。标准层面:光轮智能是Newton仿真技术指导委员会唯一中国企业,参与EgoVerse人类数据委员会,主导或参编20项国家及行业标准,并与NVIDIA共同定义SimReady标准。流通层面:觅蜂数据商城、库帕思、百度数据平台以及北京/上海/深圳数据交易所,构成了交易平台的第一批供给;北京人形机器人创新中心推动公共数据底座与标准制定。
结语
“造治用通”四个字,本质上回答的是同一个问题:数据如何从一次性消耗品变成可积累、可复售、可增值的资产。 造数据解决供给,治数据解决质量,转飞轮解决增值,通数据解决流动。四者缺一环,行业就会回到“采得少、训不好、用不了”的低水平循环。
中国具身数据产业链生态体系正在快速发展与完善中,商业机会巨大,更多板块详细分析,请关注易观分析近期发布的《中国具身智能数据产业分析报告2026》。
易观分析将及时更新《中国具身数据产业价值链生态图谱》,如果您也是具身智能产业中的一员,请及时与易观分析沟通。
易观分析也将开启对具身数据亮点企业的推荐,敬请关注。